2026-07-10
Un Spotify autoalojado: Navidrome, spotdl y una guerra contra los rate limits
Un Spotify autoalojado: Navidrome, spotdl y una guerra contra los rate limits
Parte de mi serie sobre el servidor doméstico. La meta era clara y la ejecución, menos: tener toda mi biblioteca de Spotify, favoritos y playlists incluidas, como ficheros de audio normales en la Raspberry Pi, servidos por Navidrome para que cualquier cliente Subsonic pueda hacer streaming desde donde sea.
La idea clave: Spotify es un oráculo de metadatos, no una fuente de audio
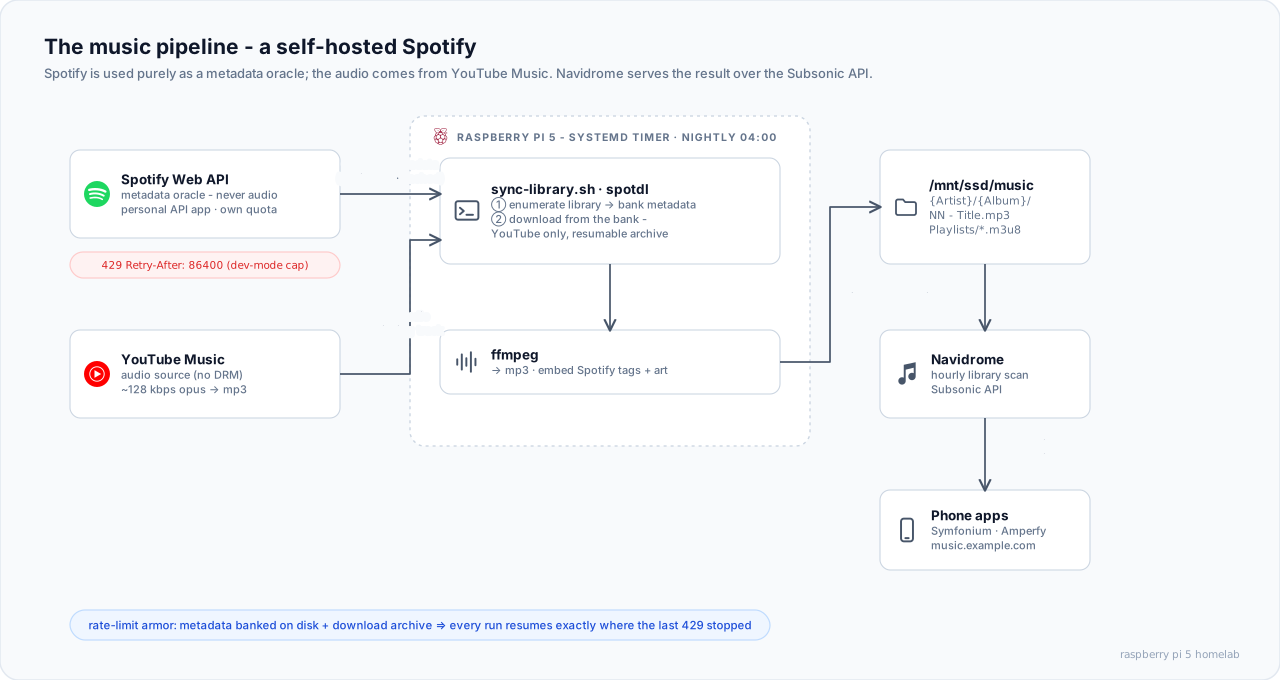
spotdl no descarga audio de Spotify. El DRM lo impide. Spotify solo aporta metadatos: títulos, álbumes, carátulas, números de pista. El audio sale de YouTube Music, sin DRM, emparejando cada pista con búsquedas del estilo "artista título álbum". El techo es el opus de ~128 kbps de YouTube Music (convertido a mp3): suficiente para móvil y desplazamientos, no un archivo maestro.
Navidrome, en cambio, es aburrido a propósito: observa una carpeta. Los ficheros van como {Artista}/{Álbum}/{NN} - {Título}.mp3. Un escaneo horario los indexa, y apps Subsonic (Symfonium, Tempo, Amperfy...) los reproducen vía el túnel de Cloudflare:
services:
  navidrome:
    image: deluan/navidrome:latest
    user: "1000:1000"
    environment:
      ND_SCANNER_SCHEDULE: 1h
      ND_BASEURL: https://music.example.com
      ND_PLAYLISTSPATH: Playlists   # importa ./Playlists/*.m3u8
    volumes:
      - ./data:/data
      - /mnt/ssd/music:/music:ro    # solo lectura: Navidrome sirve, nunca escribe
    networks:
      - proxy
Lo que me enseñó el rate limiter
La vía ingenua, una lista masiva de URLs para spotdl, murió enseguida. Cada URL obliga a una consulta de metadatos por pista. ~2.900 seguidas es justo lo que los anti-abuso de Spotify están hechos para cortar. Lo que aprendí, en el orden en que me costó tiempo:
- Evita el client ID compartido de spotdl. Lo estrangulan todos los que lo reutilizan. Una app de desarrollador propia (gratis) trae cuota separada.
- Tu app también tiene techo diario en "development mode". Pásalo y Spotify responde
429 Retry-After: 86400. Un día entero de espera. - La concurrencia activa otra alarma. Cuatro hilos martilleando el endpoint de sesión provocaron un soft-ban de IP (
Could not get session). Significa estrangulado, no roto: paciencia, no actualizar paquetes.
Lo que aguantó fue un pipeline de dos fases que minimiza contacto con Spotify:
Fase 1: enumerar y cachear. Un script Python pagina favoritos y playlists vía la API Web oficial. Esos endpoints devuelven objetos de pista completos, así que la misma pasada que lista la biblioteca vuelca metadatos a un library.spotdl en disco. Unas pocas docenas de llamadas espaciadas. Toda la huella en Spotify.
Fase 2: descargar desde caché. spotdl download library.spotdl lee metadatos locales y solo habla con YouTube. Con --archive, cada pista completada queda registrada. Las ejecuciones posteriores saltan lo hecho y bajan solo lo nuevo.
# Paso 1: enumeración paginada, metadatos a disco (el ÚNICO contacto con Spotify)
build-manifest.py  →  backfill/library.spotdl

# Paso 2: las descargas leen el banco (solo YouTube, totalmente reanudable)
spotdl download library.spotdl --archive archive \
  --output "{artist}/{album}/{track-number} - {title}.{output-ext}"
Cachear metadatos implica que un rate limit frena el avance, no lo borra. El timer nocturno (systemd, 04:00) retoma donde quedó la pasada anterior hasta completar el espejo.
El backfill: 2.906 canciones sin acabar baneado
La carga inicial pidió paranoia. Lo que fallaba no era pista a pista, sino la sesión que spotdl obtiene una vez por invocación. El bucle giró en torno a eso:
- Bloques de 30 pistas por invocación, un hilo, pausas de 12-20 s con jitter entre bloques.
- Canario primero: una pista por invocación en las ~100 primeras, para confirmar que el bloqueo se levantó antes del backfill real.
- Reanudación doble: un
cursor(siguiente línea del manifiesto, avanza solo con salidas limpias) más--archivede spotdl (verdad de "hecho"). Cada capa puede fallar sola. Juntas, un crash no cuesta progreso. - Backoff, no rendición inmediata: bloque fallido → esperas crecientes (5 min × intento, tope 1 h) y solo se abandona tras seis fallos seguidos.
La corrida completa tardó ~13 h en la Pi y dejó ~95% descargado. Reintentar rezagados recuperó casi todo. Unas ~89 canciones no tienen fuente en YouTube. Ese es el precio honesto del método.
El bug favorito de esa semana no fue Spotify: run.log creado antes por root, la redirección >> run.log sin privilegios fallaba, bash marcaba el comando como error, y el bucle lo interpretaba como rate limit y retrocedía 25 minutos sin bajar nada. En scripts largos: los exit codes mienten cuando falla una redirección.
Reconstruir las playlists
Descargar ficheros no basta: falta la sensación de tus playlists. Hacía falta mapear "canción en playlist de Spotify" → "fichero en disco". spotdl graba la URL de origen en el frame ID3 WOAS (ISRC como respaldo). Un script relee pertenencia desde la API, localiza cada pista por etiqueta y escribe un .m3u8 por playlist, más una sintética de "Liked Songs", en la carpeta que importa Navidrome (ND_PLAYLISTSPATH).
Notas desde el foso:
- La API Web no ve carpetas de playlists. El endpoint interno responde
403a OAuth normal. Un token del reproductor web (sacado de DevTools) sí las lista. Los nombres de carpeta acaban como prefijos tipoT0P / rap. - Navidrome fija el nombre
#PLAYLIST:solo en la primera importación y no poda una playlist cuando desaparece su.m3u. Renombrar o borrar exige poda manual en la base de datos. spotdl sync(modo continuo vs backfill) es espejo de verdad: borra locales cuyas canciones salieron de la playlist origen. Mejor saberlo antes de apuntarlo a una carpeta que te importe.
¿Mereció la pena?
Sí. El timer nocturno mantiene el espejo al día, las playlists se rellenan solas mientras se reintentan rezagados, y el móvil reproduce mi biblioteca desde mi hardware vía mi túnel. Spotify queda reducido a lo que hace bien: saber qué me gusta.
Siguiente en la serie: migrar Immich y las lecciones de almacenamiento de Nextcloud que lo precedieron.